Now Reading: Copilot Fusion fa scegliere l’AI all’AI. Il vero potere è decidere quale modello lavora
-
01
Copilot Fusion fa scegliere l’AI all’AI. Il vero potere è decidere quale modello lavora
Copilot Fusion fa scegliere l’AI all’AI. Il vero potere è decidere quale modello lavora

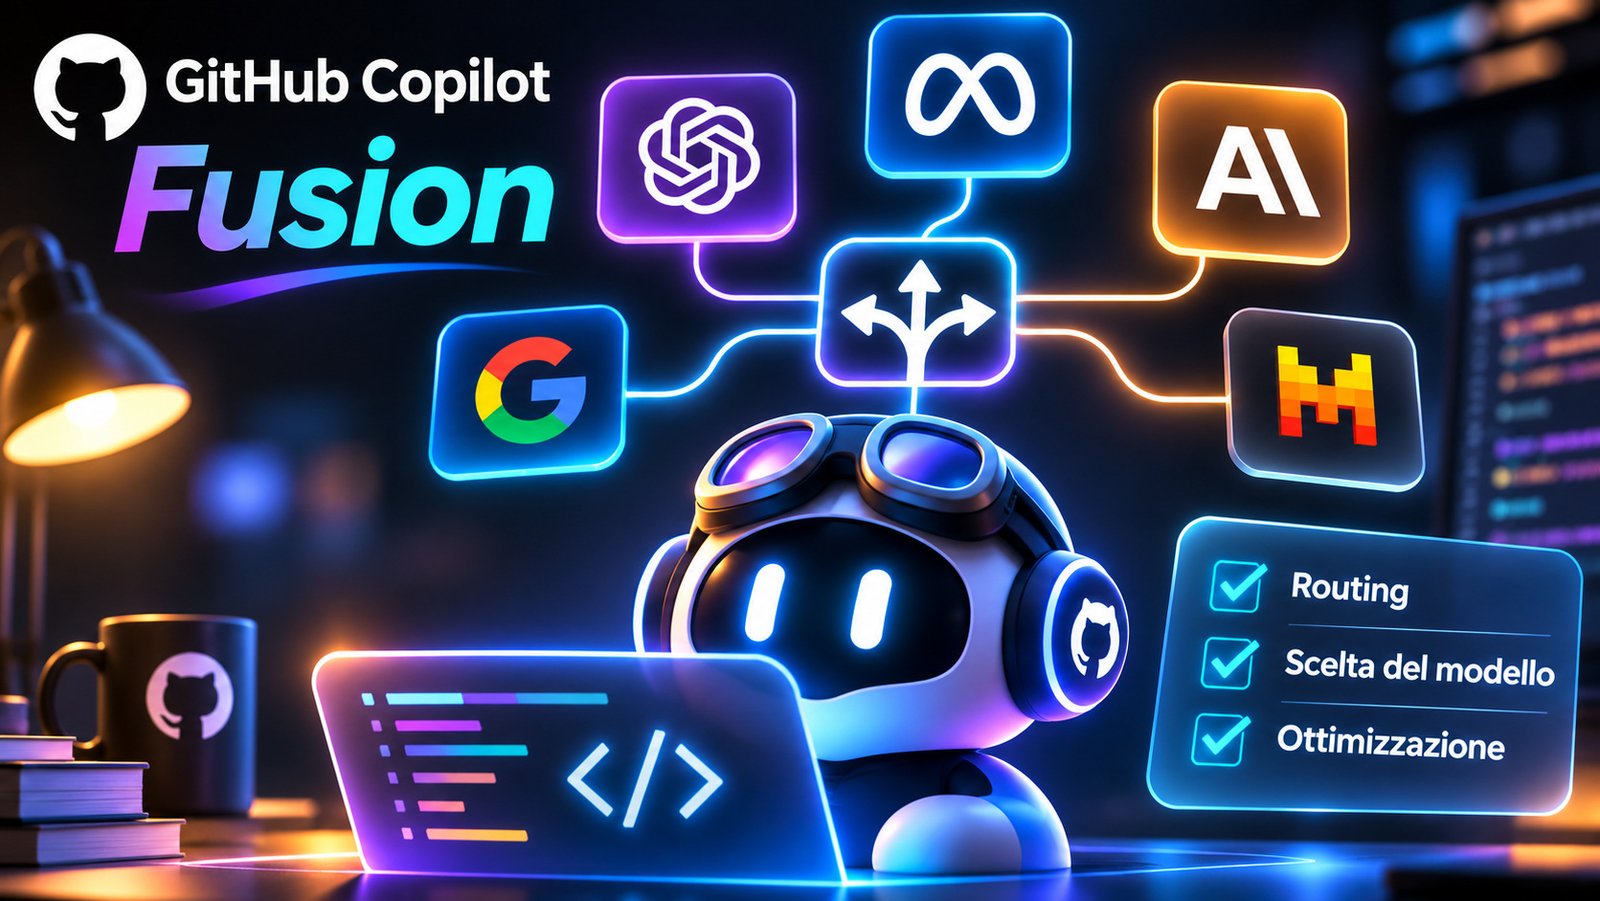
GitHub Copilot Fusion decide quale modello AI impiegare nel codice, e quando farne collaborare diversi. Più efficienza, nuovi costi e un potere di scelta che cambia proprietario.
GitHub Copilot Fusion è disponibile dal 28 ottobre 2026 e cambia la domanda che i programmatori fanno a un assistente AI. Anziché scegliere un modello per scrivere codice e un altro per controllarlo, possono selezionare Fusion e lasciare che sia il sistema a decidere chi debba lavorare. A volte basta un solo modello. In altri casi uno produce una risposta e un secondo la verifica; oppure una prima soluzione economica viene scartata per ricominciare con uno strumento più potente. La novità, annunciata durante GitHub Universe, si presenta come una scorciatoia verso il risultato. Ma aggiunge anche un nuovo intermediario tra l’utente e l’intelligenza artificiale.
Nel changelog ufficiale del 28 ottobre, GitHub descrive Copilot Fusion come la combinazione di due tecnologie già sperimentate: la selezione automatica del modello e l’orchestrazione multimodello del progetto HydraFusion. Le ragioni sono concrete. Usare sempre il modello più costoso per correggere una riga di codice è uno spreco; usare sempre quello meno capace quando una modifica può rompere l’applicazione può costare ancora di più. Fusion prova a stabilire quando servono capacità aggiuntive e quando no.
Finora ci siamo abituati a confrontare le AI come se fossero automobili: questa accelera di più, quella consuma meno, un’altra ha il motore migliore. Con il nuovo sistema l’utente può smettere di scegliere il motore. E chi gestisce il cambio automatico comincia a contare quanto chi lo fabbrica.
GitHub Copilot Fusion: cos’è e come funziona il routing dei modelli
Fusion non è un nuovo modello linguistico addestrato da GitHub. È un router e un orchestratore che analizza la richiesta e seleziona i modelli e il percorso di esecuzione. Dal selettore di Copilot si sceglie Fusion invece di un nome specifico, poi si stabilisce il livello di impegno: Standard, High o Max. Il sistema combina qualità, tempo e consumo di risorse in base a quell’indicazione, non promette che ogni richiesta venga risolta dal modello più grande.
GitHub descrive tre schemi. Nel percorso Single un solo modello svolge il lavoro. In Cascade un modello relativamente efficiente prepara una risposta e una verifica decide se accettarla oppure affidare il compito a una soluzione più forte. In Critique un modello scrive, un altro controlla e il primo corregge ciò che non supera la revisione. Sono modalità diverse di distribuire il ragionamento: non sempre l’uso di due modelli migliora il risultato e non sempre costa meno. Il valore dichiarato del router sta nel decidere quando aggiungerli.
L’interfaccia nasconde una decisione che fino a ieri era visibile. Se un modello preciso è migliore nel trovare errori e un altro nel progettare un’architettura, il sistema può assegnare loro ruoli diversi. L’utente riceve il risultato dell’intero processo. È utile, ma rende meno immediato attribuire a un singolo modello il merito di un successo o la responsabilità tecnica di un errore.
Standard, High e Max: il risparmio non è automatico
Fusion Standard è orientato ai compiti quotidiani; High privilegia capacità maggiori per richieste più difficili; Max è pensato per lavoro complesso e ragionamento impegnativo. GitHub dichiara che, nell’Artificial Analysis Coding Agent Index, Fusion Max ha ottenuto 60 punti, a due punti dal sistema Claude Code con Opus 5.5 Max, spendendo circa metà del costo API medio per attività, usando circa metà dei token e impiegando il 40% di tempo in meno. Sono risultati che GitHub riporta per quel confronto specifico: non dimostrano che tutti gli utenti risparmieranno la metà in ogni progetto.
Qui entra una condizione spesso trascurata dagli annunci sull’efficienza. GitHub fattura ogni modello effettivamente utilizzato da Fusion alla sua tariffa normale. Se un percorso richiede una revisione aggiuntiva, o un secondo tentativo, il conto può comprendere più esecuzioni. Fino al 30 novembre 2026 è previsto uno sconto del 30% sul costo dei modelli per gli utenti con un piano Copilot a pagamento. Lo sconto è temporaneo; non equivale a un prezzo strutturalmente più basso per qualunque richiesta. Le regole di funzionamento e fatturazione spiegano inoltre che il sistema cerca di conservare la cache delle conversazioni quando ciò evita sprechi.
Questa distinzione completa il quadro già descritto da Terza Pillola nell’articolo sul crollo dei prezzi dei modelli AI: il prezzo del singolo token conta, ma conta anche quanti passaggi richiede un risultato attendibile. Un modello economico che tenta cinque volte può costare più di uno costoso che risolve al primo colpo. Fusion scommette sulla capacità di governare questa differenza.
Copilot Fusion può scegliere modelli locali, ma il controllo resta nel cloud
Il 28 ottobre GitHub ha introdotto anche un’anteprima sperimentale del routing verso modelli eseguiti sul computer dell’utente. In configurazioni supportate, Fusion Standard può scegliere un modello locale invece di inviare l’elaborazione principale a un modello remoto. Su Windows esiste un percorso gestito per installare MAI Code 1.1 Flash mediante Windows ML; in Copilot CLI è possibile configurare, su sistemi compatibili, anche modelli locali riconosciuti come Qwen3.8 Flash Next. L’accesso dipende da hardware, impostazioni e client.
Un dettaglio è fondamentale: usare un modello locale in Copilot Fusion non significa usare Fusion completamente offline. GitHub precisa che le decisioni di routing vengono ancora prese nel cloud. Alcuni modelli locali possono inoltre disporre di tutele di sicurezza differenti rispetto a quelli offerti dal servizio remoto. La capacità di eseguire codice o inferenza sul proprio dispositivo e la capacità di decidere autonomamente dove inviare i dati sono due proprietà diverse.
È la stessa distinzione raccontata nella guida di Terza Pillola sull’AI locale e sul cloud. Spostare una fase del calcolo sul computer può ridurre dipendenza e trasferimenti, ma non elimina necessariamente il ruolo del provider che autentica l’utente, coordina il servizio e stabilisce le regole di utilizzo. La parola «locale» non va scambiata con una garanzia totale di autonomia.
Chi decide quale AI usare? Il nuovo potere delle piattaforme
La scelta del modello era una delle poche decisioni che i servizi AI lasciavano in modo relativamente esplicito agli utenti esperti. I benchmark, i prezzi e le classifiche aiutavano a capire se affidare un lavoro a una soluzione veloce o a una più potente. Un router automatico può liberare tempo e ridurre la necessità di conoscere decine di nomi commerciali. Ma se il router diventa la scelta predefinita, acquista il potere di distribuire richieste e spesa tra fornitori concorrenti.
GitHub afferma che i gestori aziendali possono limitare i modelli utilizzabili, escludendone alcuni da Fusion senza disabilitarli del tutto. È una garanzia operativa importante per chi deve rispettare policy interne, residenza dei dati o limiti di spesa. Non elimina però il tema di fondo: l’utente finale delega alla piattaforma il criterio con cui vengono assegnate le richieste. Se in futuro molti servizi seguiranno lo stesso schema, la competizione tra modelli potrà dipendere anche da chi ottiene un posto privilegiato nei sistemi di instradamento.
Microsoft ha presentato, nello stesso giorno, il proprio Copilot harness multimodello, un’infrastruttura comune pensata per coordinare ragionamento, strumenti ed esecuzioni lunghe su più prodotti. L’operazione suggerisce una strategia precisa: nella nuova catena del valore dell’AI, possedere il modello migliore non basta se qualcun altro controlla l’ambiente che gli assegna il lavoro. È un’ipotesi di evoluzione del mercato, non la prova che ogni piattaforma favoriserà sistematicamente i modelli di casa.
Il rischio invisibile: l’orchestrazione può moltiplicare anche gli errori
Distribuire il lavoro non garantisce che il risultato sia corretto. Un revisore AI può non accorgersi dell’errore di un altro modello; un passaggio automatico a una soluzione più forte può consumare risorse senza risolvere il problema; una correzione può introdurre una nuova regressione. La documentazione GitHub segnala persino un limite concreto: se il sistema scarta una bozza che ha già modificato file nello spazio di lavoro, quelle modifiche non vengono necessariamente annullate. L’utente deve controllare lo stato dei file prima di confermare il lavoro.
È un’avvertenza più istruttiva di molte dimostrazioni. In un editor di testo una risposta sbagliata si può ignorare; in un ambiente che crea file, corregge bug e usa strumenti, la risposta finale non racconta da sola tutte le operazioni già effettuate. La sicurezza degli agenti AI dipende quindi anche dai permessi concessi e dalla tracciabilità dei passaggi, non soltanto dal punteggio del modello.
Dal modello all’orchestratore: dove si sposta il valore dell’intelligenza artificiale
Copilot Fusion è oggi un prodotto per lo sviluppo software, disponibile nei client GitHub Copilot supportati, e i suoi risultati dipenderanno dai compiti e dai contesti concreti. Ma rende leggibile una tendenza più ampia: i modelli diventano componenti che possono essere combinati, sostituiti, chiamati solo quando servono. La novità commerciale non è un cervello in più da mettere a catalogo: è un sistema che promette di sapere quando usare quelli già disponibili.
Per i produttori di modelli questo può significare maggiore concorrenza sul costo e sull’efficacia per singolo compito. Per gli utenti può significare meno configurazioni e, talvolta, minore spesa. Per chi controlla il router significa presidiare una nuova porta d’ingresso. Prima chiedevamo quale intelligenza artificiale fosse la più intelligente. Ora possiamo lasciare che sia una piattaforma a rispondere per noi. Resta da capire quanto diventerà conveniente non farci più vedere come ha scelto.